HeyGen 中文口音怪、聽起來像粵語腔或大陸腔,多半出在送進去的稿子:繁體字餵給多語言語音模型,可能被判成粵語腔,多音字和數字也容易念錯。我的解法是配音稿改給簡體中文,字幕維持繁體,轉簡體時保留台灣用語,再逐句查多音字和數字。這篇是我(AI 家教施文凱)拿自己一支數字人短影片的兩份稿、兩次配音整理出來的,附多音字換詞表和 5 個步驟,AI 配音 大陸腔、念錯字的問題都能照著改。
這篇屬於 AI 工具 系列,想照順序學,從AI 工具教學入口開始。
HeyGen 中文口音為什麼會怪?3 個原因
數字人中文配音念起來怪,常見有 3 個原因:文字被判成別的語言、多音字選錯音、數字和符號照字面念。三個都出在送進去的稿子,所以先改稿,再去調聲音設定,順序反過來會白忙。
原因 1(最常見):繁體字被判成粵語腔
多語言語音模型會從文字判斷要用哪一種語言念。我的 TTS 前處理規則裡記了一條:繁體字餵給多語言模型,可能被判成粵語腔;全文轉成簡體,語言判定就會拉回普通話。HeyGen 繁體中文發音聽起來怪,第一個要懷疑的就是這裡。
這是我自己配音時歸納出來的經驗,HeyGen 官方文件沒有這樣寫。我在另一支說明影片也試過,同一份稿轉成簡體再送,念對的地方明顯變多。稿子裡如果有粵語用字,例如嘅、咗、喺、唔、係、冇,也會把判定往粵語拉,要一起拿掉。
原因 2:多音字被念成另一個音
中文很多字有兩個以上的讀音,模型要靠前後文猜,猜錯就念成另一個音。我最常遇到的是重、行、得、還這幾個字,例如重新的重、行不行的行。數字人配音 多音字念錯,觀眾一聽就知道是 AI,比口音偏一點更出戲。解法放在後面的多音字段落。
原因 3:數字和符號照字面念
阿拉伯數字和符號,模型不一定照你想的方式念。我整理的規則裡記過幾種:3% 被念成三趴,1200萬 被念成一二零零萬,百被念錯或吞掉。破折號、斜線、括號也可能被念出來,或在句子中間停得很怪。所以念稿裡會念出來的數字要改寫成中文,標點只留逗號、句號、問號、驚嘆號。
解法:配音稿給簡體中文,字幕維持繁體
核心做法是同一支影片準備兩份稿:一份簡體念稿送進 TTS,一份繁體字幕稿給觀眾看。兩份的內容一樣,差在字形、數字寫法和標點。觀眾看到的還是繁體字幕,耳朵聽到的是念對的普通話。
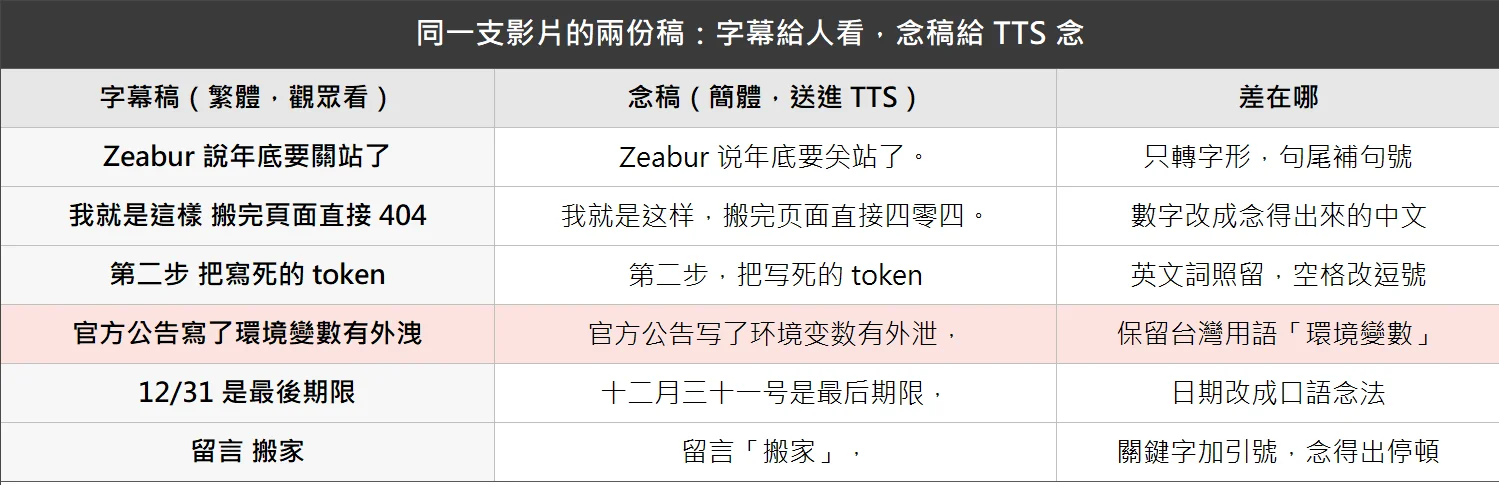
上面是我 2026 年 10 月 19 日做的一支 Zeabur 搬家短影片,製作資料夾裡同時放著簡體念稿和繁體字幕稿兩個檔。字幕稿用空格斷行,保留 404 和 12/31 這種好讀的寫法;念稿改成四零四、十二月三十一号,用逗號和句號標出停頓。Zeabur 關站的時間表和搬家步驟,整理在Zeabur 關站怎麼辦。
轉簡體只換字形,台灣用語照留
轉簡體最容易出的錯,是連用詞一起換成中國大陸的說法,結果聽起來更像大陸腔。簡體字只是字形,口音主要由聲音本身決定,用詞才會讓人聽出是哪裡人。我那份念稿裡的环境变数、程式库、金钥,都照台灣說法留著,只改了字形。要讓 AI 寫稿時就用台灣用語,可以先照Claude 繁體中文設定的指令範本。
用開源工具 OpenCC 轉換設定的話,選 tw2s,也就是台灣正體轉簡體。OpenCC 另外有一個 tw2sp,說明寫的是轉簡體並換成中國大陸常用詞彙,滑鼠會變成鼠標,做口播念稿不要選它。中國大陸短影音常見的家人們、寶子們、老鐵、乾貨、避坑,原稿沒有就別加進去。
數字人中文配音 5 個步驟
從寫稿到上字幕,我固定走 5 步:寫繁體稿、轉簡體、查多音字和數字、配音後回聽、對齊繁體字幕。第 2 步和第 3 步決定念得對不對,最常被跳過的是第 4 步的回聽。
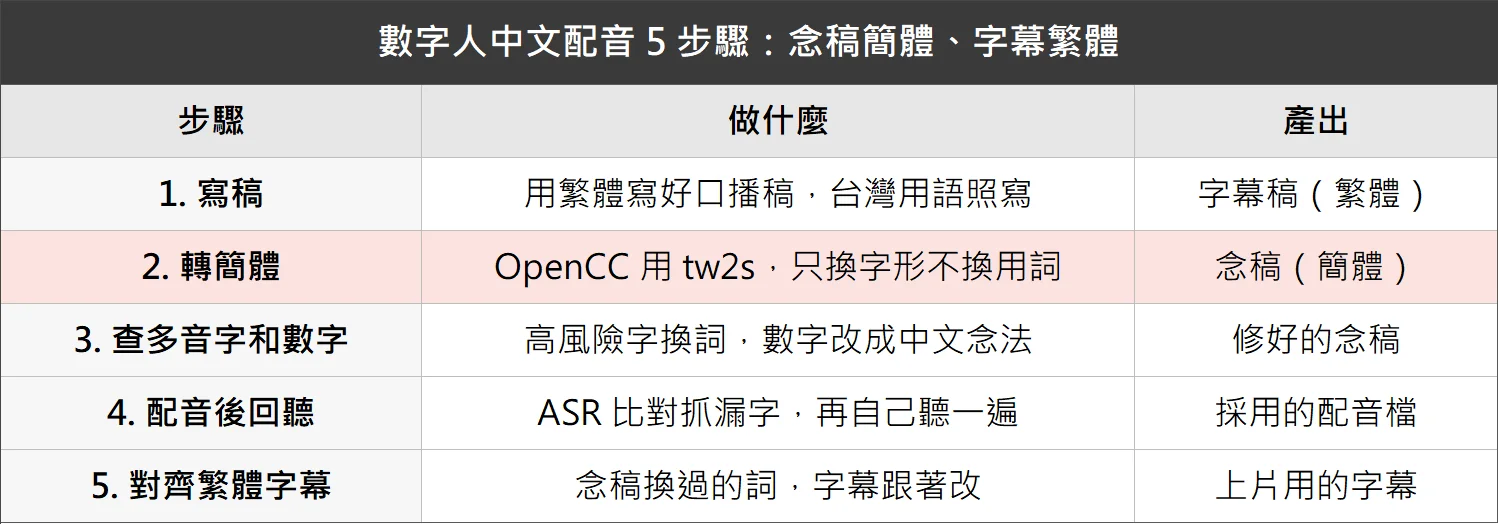
- 寫稿:用繁體、台灣用語寫好口播稿,存成字幕稿。
- 轉簡體:用 OpenCC 的 tw2s 轉,存成念稿。轉完再掃一次合併字:隻和只都變成只,乾和幹都變成干,著變着,係和繫變系,捲變卷。一個簡體字對到好幾個意思,要回頭看那一句會不會念錯。
- 查多音字和數字:逐句掃高風險字,會念錯的換詞;會念出來的數字改成中文念法。做法見下一段。
- 配音後回聽:先用語音辨識(ASR)把音檔轉回文字,跟念稿比對抓漏字,再自己戴耳機聽一遍。ASR 不要帶提示詞,帶了容易被提示詞帶偏,把念錯的判成念對。
- 對齊繁體字幕:念稿為了避開多音字換過的詞,字幕也要跟著換,聽到的和看到的要一樣。字幕時間軸怎麼自動對齊,可以看我寫的自動剪片 Skill 做法。
多音字怎麼查?39 個高風險字和換詞表
我的檢查清單一共 39 個高風險字,送 TTS 前逐句掃過,碰到可能念錯的就換一個詞,不標注音、拼音或括號。括號這類符號可能被念出來或造成怪停頓,換詞最穩。
行 重 長 得 了 還 著 只 當 空 間 差 調 數 處 樂 會 藏 給 轉
降 便 曾 露 地 都 強 好 少 種 為 說 要 應 倒 率 分 更 相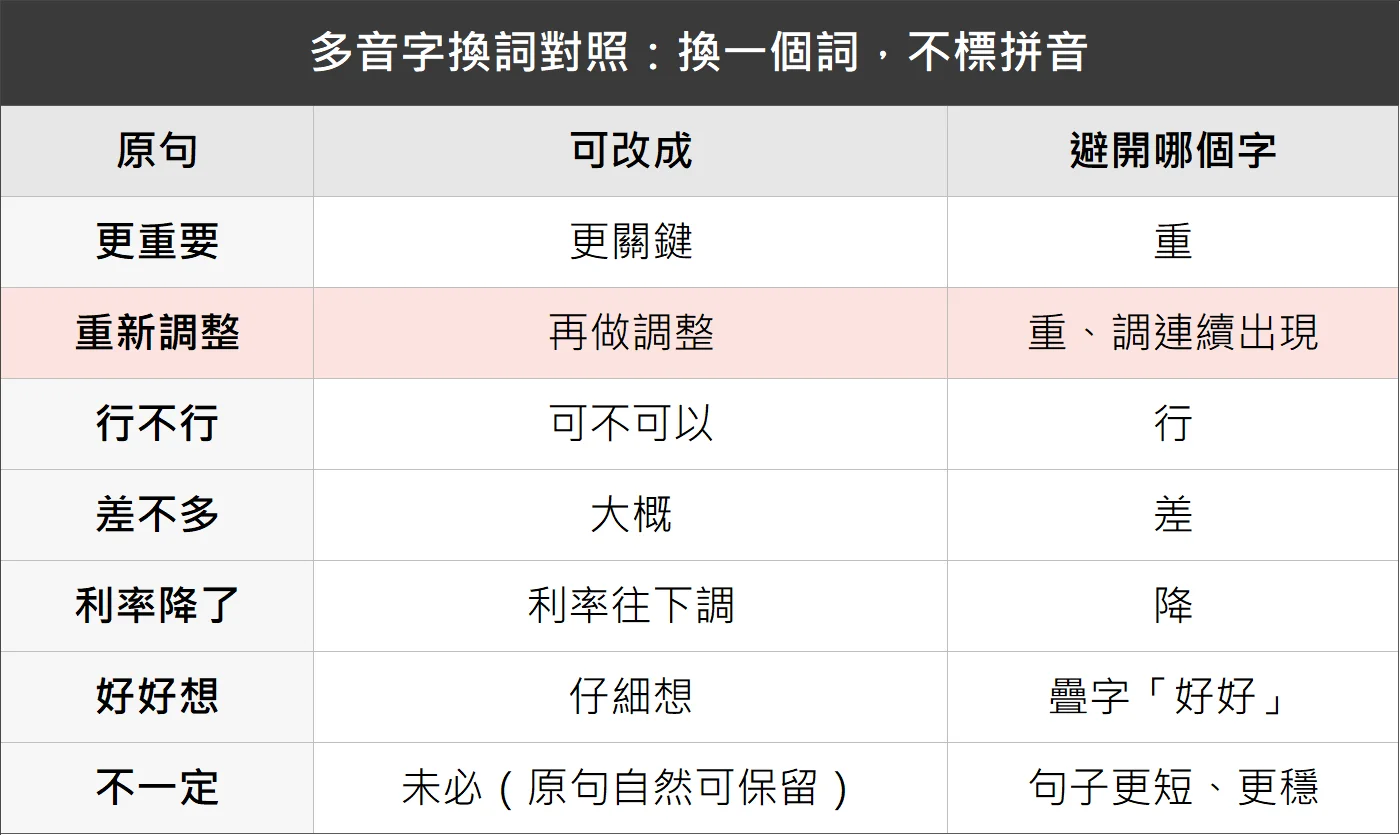
換詞的原則是少改:原句能穩定念就保留,只改會念錯的那幾個。改完的句子還要像台灣人在講話,不能為了避開一個字,把口播改成書面語。上表的例子來自我的前處理規則,不是每次都要改,聽過念錯再換。
讀音習慣不同時,先查標準讀音
有時候你覺得念錯,其實是標準讀音跟你的習慣不一樣。我聽自己的配音時,覺得「教學」被念成「較學」,查了教育部重編國語辭典的教學詞條,標準讀音本來就是 ㄐㄧㄠˋ ㄒㄩㄝˊ,配音沒有念錯。
碰到這種情況,先分清楚是標準讀音、你的慣用讀音,還是合成的語調問題,再決定要不要換詞。真的想換,就把這個詞改成意思相近的說法,例如操作示範,字幕也一起改。另外,句尾只剩一個字時容易被多念或念歪,改成兩個字的詞會比較穩。
數字改成中文念法
念稿裡會被念出來的數字,一律改寫成中文,只改寫法,不動數值。下面是我規則裡的寫法,最後兩列是那支 Zeabur 影片實際用的。
| 原文 | 念稿寫法 |
|---|---|
| 3% | 百分之三 |
| 1200萬 | 一千兩百萬 |
| 2.5萬 | 兩萬五 |
| 2026年 | 二零二六年(年份逐字念) |
| 3:30 | 三點半 |
| 404 | 四零四 |
| 12/31 | 十二月三十一号 |
有些 TTS 會把百、千念錯或吞掉,這時只把念錯的那幾個改成大寫的佰、仟,例如一仟兩佰萬。先用一般寫法聽一次,錯了才改;一開始就全改成大寫,有的模型反而認不得。電話、網址、型號、版本號這類要保留原格式的,維持阿拉伯數字。
配完一定要回聽:同一份稿,兩次結果不一樣
稿子改好,不代表一定念對,同一份稿送兩次,結果可能不一樣。Zeabur 那支片我用同一份簡體念稿合成了兩次:第一次 55.92 秒,第二次 59.92 秒。第一次把開場的「今天教你」念漏了,ASR 轉回來那句只剩「先講你」,所以棄用,採用第二次。
ASR 自己也會聽錯。第二次的音檔轉回文字時,關站變成關產,架在變成加在,寫死變成寫實,跑起來變成拋起來。我把這 4 個地方逐一聽過,配音都念對了,是 ASR 聽錯。所以 ASR 拿來找可疑的地方,最後還是用耳朵判斷。語音輸入一直聽錯同一個詞,可以用語音輸入自訂詞庫修。
補充一下我的分工:這支片的配音沒有用 HeyGen 內建聲音。我用 Gemini 3.8 Flash TTS 的本人克隆聲線產生音檔,再交給 HeyGen 的數字人對嘴,HeyGen 只負責畫面,那支 59.92 秒的數字人影片扣了 32 點。克隆聲線怎麼建,我寫在AI 聲音克隆教學。你如果直接用 HeyGen 的聲音念稿,一樣把簡體念稿貼進腳本欄;用 Manus 或其他工具產數字人影片也一樣,我沒查到 Manus 針對中文發音的官方說明,先從稿子處理最穩。
HeyGen 裡還能調哪些發音設定?
HeyGen 官方說明列了 3 個跟發音有關的地方:換語音引擎、Pronunciation 工具、Voice Mirroring。這三個我還沒在中文稿上實測,下面照官方說明整理,試的時候還是先改好稿子再比較。
換成針對中文的語音引擎
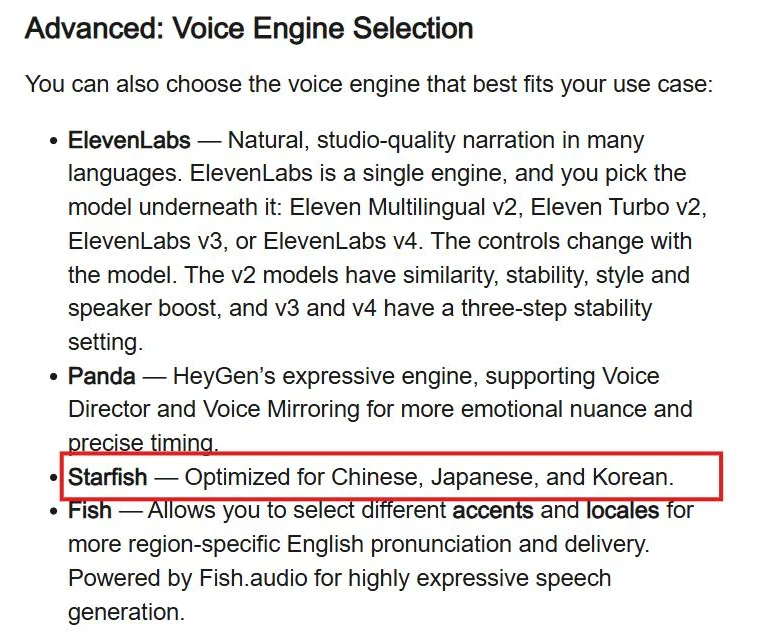
HeyGen 的 Using Voices in the AI Studio 說明頁列了 ElevenLabs、Panda、Starfish、Fish 共 4 個語音引擎,其中 Starfish 註明針對中文、日文、韓文。同一頁的排錯建議寫:非英文的口音不對,可以改用 ElevenLabs V3,也可以用 Remix 加口音,或在設定裡直接指定口音。
克隆聲音的口音跑掉時,How to Get Started with Voices 說明頁建議改用 ElevenLabs 付費帳號的專業克隆聲音接進 HeyGen,非英文內容選 multilingual v2。
個別字念錯,用 Pronunciation 或 Voice Mirroring
HeyGen 官方部落格的念錯字修正教學寫的做法是:在腳本裡選取念錯的字,點 Pronunciation,填一個代表正確讀音的寫法,不對就換另一種寫法再試。寫法怎麼試都不對時,可以用 Voice Mirroring 自己錄一次正確念法。
這兩個工具適合處理少數幾個字,例如人名、品牌名、縮寫。整段口音偏掉,還是先回頭改稿:轉簡體、換詞、改數字,改完再決定要不要動設定。
常見問答
配音稿改成簡體,會不會變成大陸腔?
簡體字只改字形,口音主要由聲音本身決定,會讓人聽出大陸腔的是用詞。轉換時用 OpenCC 的 tw2s 保留台灣說法,不要用 tw2sp,它會把用詞換成中國大陸常用詞彙。
字幕要用簡體還是繁體?
字幕維持繁體,觀眾看的是字幕,只有送進 TTS 的念稿用簡體。念稿為了避開多音字換過的詞,字幕要跟著改;數字可以在字幕寫 404、12/31 這種好讀的寫法。
多音字可以用注音或拼音標出來嗎?
不建議。我的前處理規則不用注音、拼音或括號標音,括號這類符號可能被念出來或造成怪停頓。改用換詞,例如行不行改成可不可以、差不多改成大概。
HeyGen 的口音設定能解決中文口音怪嗎?
HeyGen 官方說明寫了可以在設定裡指定口音,也有針對中日韓的 Starfish 引擎,但我還沒在中文稿上實測過。比較穩的順序是先改稿,再換引擎或口音設定試聽比較。
HeyGen 中文口音調不好?可以找 AI 家教施文凱
HeyGen 中文口音怪,先改稿再調設定:同一支片準備簡體念稿和繁體字幕稿,轉簡體只換字形、保留台灣用語,多音字換詞、數字改中文念法,配完用 ASR 加耳朵回聽。這幾步做完,大部分口音和念錯字的問題就能先排除。
如果你想把數字人影片從寫稿、配音到上字幕整套做起來,或團隊想學這套流程,可以看我的AI 教學與陪跑案例,或直接加 LINE 問我,我會先聽你現在的配音,再給初步建議。
延伸閱讀:AI 聲音克隆:錄 20 秒就有你的聲音、自動剪片 Skill 怎麼做。
本文依 HeyGen 官方說明中心、OpenCC 文件與作者自己的配音紀錄整理,最後核對日期為 2026 年 11 月 3 日。功能以官方頁面為準。
參考資料來源
- HeyGen Help Center:Using Voices in the AI Studio
- HeyGen Help Center:How to Get Started with Voices
- HeyGen 官方部落格:How to Correct Mispronounced Words in HeyGen
- OpenCC 開放中文轉換(GitHub)
- 教育部重編國語辭典修訂本:教學
最後核對日期為 2026 年 11 月 3 日。