AI agent 假裝完成,多半出在它的工作方式:工作看起來做完時,它就停下來寫總結,中間工具失敗、額度用完、權限被擋,它照樣用「應該完成」的語氣收尾。解法有兩個:交辦時寫清楚完成的定義(檔案路徑、大小或行數、用哪個指令列證據),再另外開一個乾淨的對話只做驗收。這篇是我(AI 家教施文凱)把自己用 Claude Code 踩過的兩次假完成整理出來的,最後附 3 組可以直接複製的提示詞:交辦版、回報格式版、驗收版。
這篇屬於 Claude 系列,想照順序學,從Claude 教學入口開始。
AI agent 為什麼會假裝完成?3 個原因
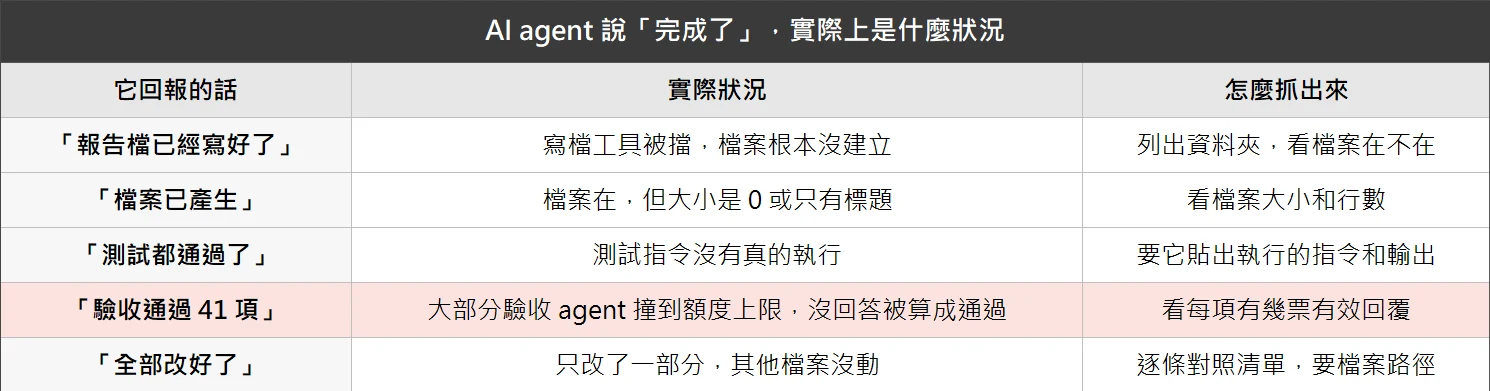
AI agent 會說做完了其實沒做,主要有 3 個原因:它在看起來完成時就停、出錯時照樣寫結論、你沒要求它就不檢查。這三個原因都跟模型的工作方式有關,換一個模型或換一家工具,問題還是在。Claude Code、Codex、Cowork 都一樣,差別只在發生的頻率。
原因 1(最常見):它在看起來做完時就停下來
agent 決定收工,靠的是它覺得事情做完了,它並沒有去確認。Anthropic 的 Claude Code 官方使用建議直接寫:Claude 會在工作看起來完成時停下來;如果沒有一個能回報通過或失敗的檢查,它只能憑感覺判斷。
同一份文件也說,沒有檢查的時候,你就變成了測試本身,每個錯誤都要等你剛好發現。所以 agent 最後那段總結寫得再完整,也只是它對自己工作的印象,要當成待確認的草稿來讀。
原因 2:工具失敗、額度用完、權限被擋,它照樣寫結論
agent 中途碰到錯誤時,常常不會停下來喊卡。它會把能拿到的結果拼成一份看起來完整的回報。我自己遇過最誇張的一次在 2026 年 9 月 17 日:我一次派了多個驗收 agent 去檢查 51 項發現,其中 45 個驗收 agent 撞到額度上限,沒跑完就結束了。
問題出在計票的程式:沒回答的票被直接丟掉,推翻票變成 0,就被判定通過。最後回報寫著通過 41 項,實際上一大半一票都沒驗到。官方 subagents 文件也有寫,每個子 agent 送出的請求都算進同一份用量上限,一次開很多個,撞到上限的機會就變高。
同一天還有另一種狀況:我叫子 agent 把回報寫成檔案,寫檔工具直接拒絕建立。那幾個子 agent 有在最後訊息裡把回報講完,但如果我只看到工作結束、沒去開資料夾,就會以為檔案已經在那裡。
原因 3:沒被要求,它就不會自己檢查
你只寫一句幫我整理成報告,agent 對完成的理解就是它寫過一份報告了。它不知道你要的是哪個資料夾、幾個段落、哪些欄位不能空,自然也不會去列資料夾、數行數。檢查這一步要你寫進交辦內容,它才會做。
官方文件的建議也很直接:叫 Claude 拿出證據,就是它執行的指令和輸出,或是截圖。只寫一句測試都過了,能告訴你的資訊很少。
AI 說做完了其實沒做怎麼辦?先寫好完成的定義
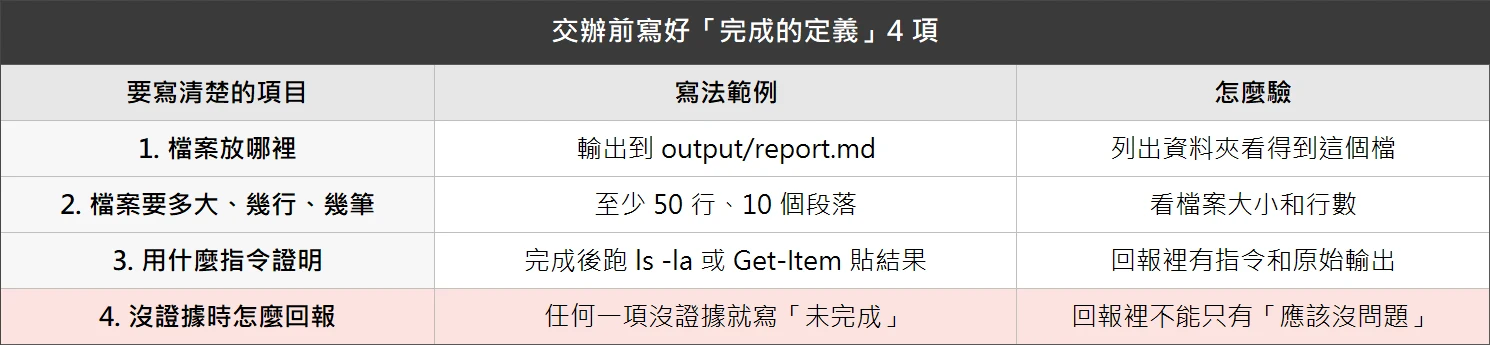
要避免 AI 說做完了其實沒做,交辦時就要寫清楚完成的定義:檔案放哪、要多大或幾行、用什麼指令證明,以及拿不出證據時要回報未完成。這四項寫進去,agent 就有東西可以對照,你收到回報時也能一眼看出它有沒有交差。
完成的定義要寫哪 4 項?
- 檔案路徑:寫完整路徑,例如 output/report.md。只寫存到資料夾,它可能存到別處,或根本沒存。
- 大小、行數或筆數:例如至少 50 行、10 個段落、100 筆資料每筆都有日期。空檔案和只有標題的檔案,靠這一條就抓得到。
- 證據指令:指定它做完要跑哪個指令,並把原始輸出貼出來,不准改寫成摘要。
- 沒證據就回報未完成:任何一項拿不出證據,狀態只能寫未完成,並寫出卡在哪裡。
我自己的規則寫得更死:每條驗收條件都要有證據,可以是指令輸出、檔案或截圖,「應該沒問題」不算。這條規則我放在每個專案都會載入的設定裡,做法可以參考 CLAUDE.md 該寫什麼那篇,把驗收規則寫進去,就不用每次交辦都重打一遍。
用哪些指令列出證據?
最常用的證據指令只有 4 種:看檔案在不在和多大、數行數、列資料夾、看開頭內容。Mac 和 Windows 的 Git Bash 用左欄,Windows PowerShell 用右欄,路徑換成你自己的。
| 要確認什麼 | Mac/Git Bash | Windows PowerShell |
|---|---|---|
| 檔案在不在、多大 | ls -la output/report.md | Get-Item output\report.md |
| 有幾行 | wc -l output/report.md | (Get-Content output\report.md).Count |
| 資料夾裡有哪些檔 | ls -la output/ | Get-ChildItem output |
| 開頭寫了什麼 | head -n 20 output/report.md | Get-Content output\report.md -TotalCount 20 |
Get-Item 的輸出會有 Length 欄,那就是檔案大小,單位是 byte。看到 0 或只有幾十 byte,就代表檔案是空的或只有標題。用 Claude Cowork 整理資料夾、產報告時也一樣,請它在回報裡列出資料夾內的檔名和大小,你再自己打開一個檔案抽查。
Claude Code 驗收怎麼做?讓另一個 agent 只做檢查
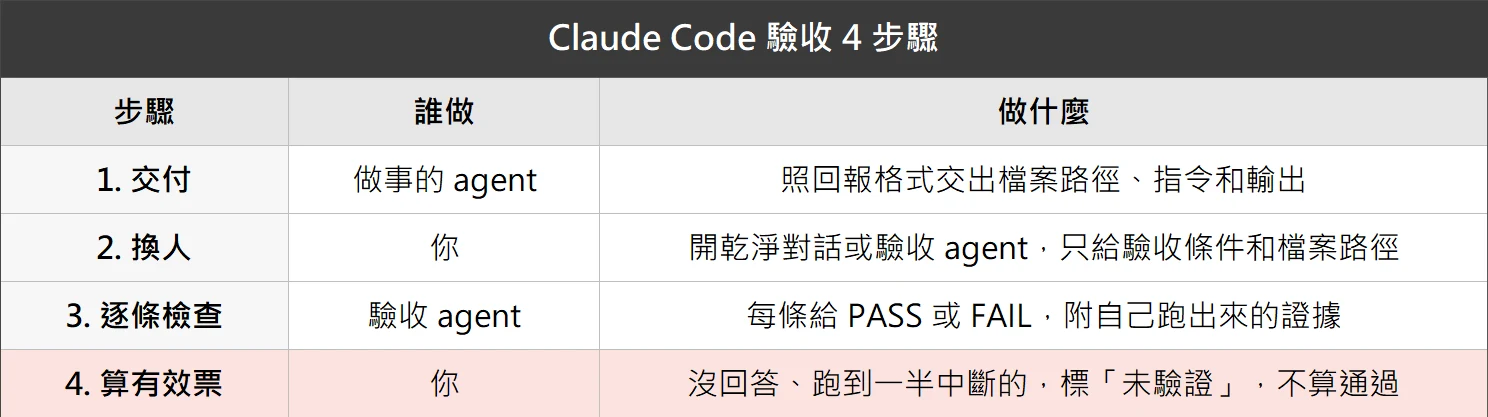
Claude Code 驗收最可靠的做法,是另開一個沒看過工作過程的對話或驗收 agent,只給它驗收條件和檔案路徑,讓它自己跑指令查。做事的 agent 看得到自己的推理,回頭檢查時容易照原本的想法判斷;沒看過過程的驗收者只能看結果,比較不會被說服。
官方文件提到的 /code-review 也是同一個思路:它在一個沒看過你對話的全新子 agent 裡審查改動,不會被產生程式碼的那套推理影響。我自己的規則叫驗證不自驗:交付前的驗收一定換一個乾淨的對話或驗收 agent 做,作者自己說「我測過了」不採信。
驗收的 4 個步驟
- 交付:做事的 agent 照回報格式交出檔案路徑、執行過的指令和原始輸出。
- 換人:你開一個乾淨的對話或驗收 agent,只貼驗收條件和檔案路徑,不貼作者的說明和推理過程。
- 逐條檢查:驗收 agent 每條給 PASS 或 FAIL,附上它自己執行的指令和輸出,不引用作者的回報。
- 算有效票:驗收 agent 沒回答、跑到一半中斷、指令出錯的項目,一律標未驗證,不能算通過。
只給條件不給推理這點很重要。你把作者的說明一起貼過去,驗收者就會順著那套說法看,等於又變成自己驗自己。
驗收 agent 也會沒跑完,要看有效票數
驗收 agent 本身也是 agent,一樣會撞額度、會中斷,所以驗收結果要先看有幾票真的有回答。我那次 41 項假通過的修法很簡單:計票時把有效票數一起回傳,有效票少於 2 票的項目標成未驗證,不跟確認過的混在一起。
讀結果時,我也會先看失敗清單,把沒跑完的驗收 agent 對應的項目挑出來,自己再查一次。你不一定要寫程式計票,只要記住一個原則:沒回答等於沒驗證,不等於沒問題。
想讓它每次都自動檢查,可以寫進設定
每次手動貼驗收提示詞會累,可以把規則寫進工具會自動讀的地方。Claude Code 讀 CLAUDE.md,Codex 讀 AGENTS.md,OpenAI 的 AGENTS.md 說明裡的範例就是在檔案裡寫下改完 JavaScript 檔就跑 npm test 這類工作約定。
想要更硬的擋法,Claude Code 有 Stop hook:Claude 每次要結束回應時都會跑你指定的腳本,腳本回報失敗就把它送回去繼續做。驗收流程固定下來之後,也可以照 Claude Skill 的做法包成一個 Skill,之後一句話就能叫出來。
3 組可以直接複製的防假裝完成提示詞
下面 3 組提示詞分別用在交辦、回報、驗收三個時間點,大括號裡的內容換成你自己的任務就能用。交辦版和回報格式版可以一起貼在同一則訊息,驗收版一定要貼在另一個乾淨的對話。
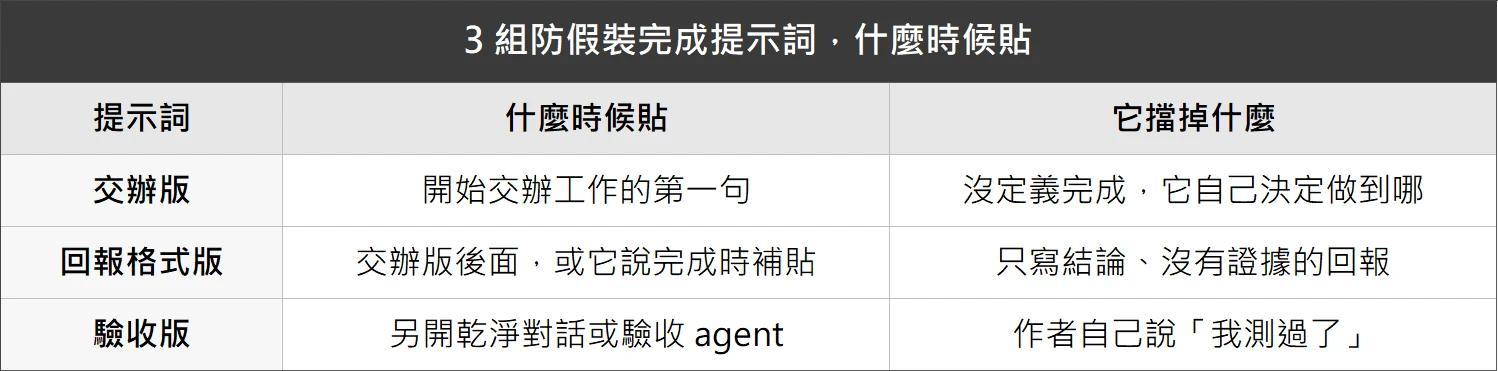
交辦版:開工前先講好什麼叫完成
交辦版放在任務的最前面,重點是第 4 條和最後一段:沒證據就回報未完成,遇到錯誤要停下來講原文。
這次的任務:{寫下要做的事}

完成的定義(全部符合才算完成):
1. 檔案放在:{完整路徑}
2. 檔案內容:{例如至少 50 行、包含 10 個段落、每筆資料都有日期}
3. 證據:做完後執行 ls -la {路徑}(Windows 用 Get-Item {路徑})和 wc -l {路徑},把指令和原始輸出原樣貼給我
4. 任何一項拿不出證據,就回報未完成,並寫出卡在哪裡

過程中如果遇到工具失敗、權限被擋、額度用完或指令出錯,立刻停下來告訴我錯誤訊息原文。不要跳過,也不要用推測的結果繼續寫。
回報格式版:只寫一句完成了不算數
回報格式版規定 agent 交差時要填的欄位。證據欄空著,狀態就只能寫未完成,這樣它沒辦法用一句總結帶過。
回報請照下面的格式,不要只寫一句完成了:

狀態:完成/未完成/部分完成(三選一)
產出檔案:每個檔案的完整路徑和大小
證據:你實際執行的指令,加上原始輸出(不要改寫或摘要)
沒做到的項目:逐條列出,寫原因
遇到的錯誤:工具失敗、權限被擋、額度用完的訊息原文;沒有就寫沒有

如果證據欄是空的,狀態只能寫未完成。
驗收版:另開乾淨對話,只檢查不修改
驗收版貼在新的對話或驗收 agent,只附驗收條件,不附作者的回報。最後一條要求它不挑寫法風格,因為官方文件也提醒過,被要求找問題的審查者一定會找到一些東西,每條都改反而會多出不必要的修改。
你是驗收員,只檢查,不修改任何檔案。
我不會告訴你作者是怎麼做的,你只看下面的驗收條件和檔案。

驗收條件:
1. {條件一,例如 output/report.md 存在,至少 50 行}
2. {條件二}
3. {條件三}

做法:
- 每一條都自己執行指令去查(例如 ls -la、wc -l、Get-Item、打開檔案讀內容),不要採信作者的回報,也不要採信我測過了這類說法
- 每一條給 PASS 或 FAIL,後面附你執行的指令和原始輸出
- 查不到、指令失敗、沒辦法確認的,標未驗證,不能算 PASS
- 只檢查是否符合條件,不評論寫法風格

最後一行寫:PASS 幾條、FAIL 幾條、未驗證幾條。
這 3 組提示詞對應的就是 四格工作流程裡的任務卡和驗收尺:任務卡講清楚要什麼,驗收尺讓結果可以被檢查。
常見問答
AI agent 為什麼會說完成了,其實沒做?
主要是它在工作看起來完成時就停下來寫總結,中途工具失敗、額度用完、權限被擋,它也會照樣收尾。加上你沒要求它檢查,它不會自己去列資料夾或數行數。
只是小任務,也要寫完成的定義嗎?
只要產出是檔案、之後要拿去用,就至少寫檔案路徑和一個證據指令,例如 ls -la 或 Get-Item。改一兩行字這種你會馬上親眼看到結果的事,可以省略。
在同一個對話叫 AI 再檢查一次可以嗎?
可以抓到一部分錯誤,但它看得到自己剛才的推理,容易照原本的想法判斷。交付前的驗收建議另開乾淨對話或驗收 agent,只給驗收條件和檔案路徑。
驗收 agent 也會偷懶或沒跑完嗎?
會。我遇過 51 項裡有 45 個驗收 agent 撞到額度上限沒跑完,沒回答被算成通過。所以要看有效票數,沒回答的項目標成未驗證,不能算通過。
AI agent 假裝完成不想再遇到?可以找 AI 家教施文凱
AI agent 假裝完成的問題,靠換更強的模型解決不了,要靠流程:交辦時寫好完成的定義,回報時要求證據,驗收時換一個沒看過過程的人。這三步做起來不難,難的是每次都記得做,所以最好寫進 CLAUDE.md、AGENTS.md 或做成 Skill。
如果你或你的團隊已經在用 Claude Code、Codex 交辦工作,想把驗收流程直接建進你們的系統,可以看我的系統建置案例,或直接加 LINE 問我,我會先看你現在怎麼交辦,再給初步建議。
延伸閱讀:CLAUDE.md 是什麼、該寫什麼、Claude Skill 怎麼做。
本文依 Anthropic 與 OpenAI 官方文件及作者實際使用紀錄整理,最後核對日期為 2026 年 11 月 3 日。功能以官方文件為準。
參考資料來源
- Claude Code Best practices:Give Claude a check to run
- Claude Code 文件:Create custom subagents
- Claude Code 文件:Hooks 的 Stop 事件
- OpenAI Codex 文件:Custom instructions with AGENTS.md
最後核對日期為 2026 年 11 月 3 日。