語音輸入自訂詞庫,就是一張原本聽成什麼、自動改成什麼的對照表,專門修產品名聽錯、英文亂拼這類每次都錯在同一處的字。我是 AI 家教施文凱,每天用語音輸入對 AI 下指令,自己維護一份 409 條的詞庫規則,這篇大部分的例子都從那份詞庫和 174 筆錄音紀錄裡挑出來。還沒開過語音輸入的話,先看 AI 語音輸入怎麼開;這篇只講聽錯之後怎麼修,分成專有名詞、英文、句子開頭 3 種錯,最後補上 Whisper 轉逐字稿時怎麼提示專有名詞。
這篇屬於 AI 工具 系列,想照順序學,從AI 工具教學入口開始。
語音輸入最常見的 3 種錯,原因各不一樣
語音輸入的錯,大部分可以歸成 3 種:專有名詞聽錯、英文亂拼、句子開頭不見。前兩種是辨識結果錯,用詞庫修;第三種多半是錄音或潤稿那一步出事,詞庫修不到。還沒決定用哪個語音輸入工具,可以先看語音輸入推薦。
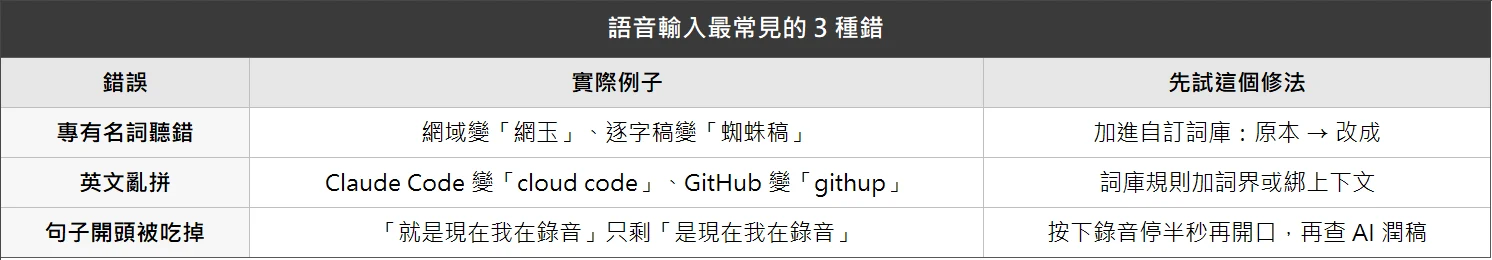
- 原因 1(最常見):專有名詞聽錯。辨識模型沒聽過你的工作用語,只好挑發音接近的常用字。我的紀錄裡,網域被聽成網玉,逐字稿被聽成蜘蛛稿。
- 原因 2:英文亂拼。中文句子裡夾英文產品名,模型會拼成發音接近的英文單字,像 Claude Code 變成 cloud code、GitHub 變成 githup。
- 原因 3:句子開頭被吃掉。按下錄音鍵就開口,前一兩個字沒收到;或是錄到了,卻被 AI 潤稿當成贅字刪掉。
專有名詞一直聽錯?語音輸入自訂詞庫怎麼建
專有名詞聽錯,最直接的修法是建一份自訂詞庫:辨識完成後,工具照表把錯字換成正確的字再貼出來。它不會讓模型聽得更準,但同一個錯字只要寫過一次規則,之後每次都會被換掉。
詞庫規則怎麼寫?原本、改成、類別 3 欄就夠
一條詞庫規則只要 3 欄:原本聽成什麼、要改成什麼、屬於哪一類。我把規則存成一份 CSV,用小工具寫進語音輸入軟體的字典,CSV 是唯一正本,軟體升級也不會被蓋掉。
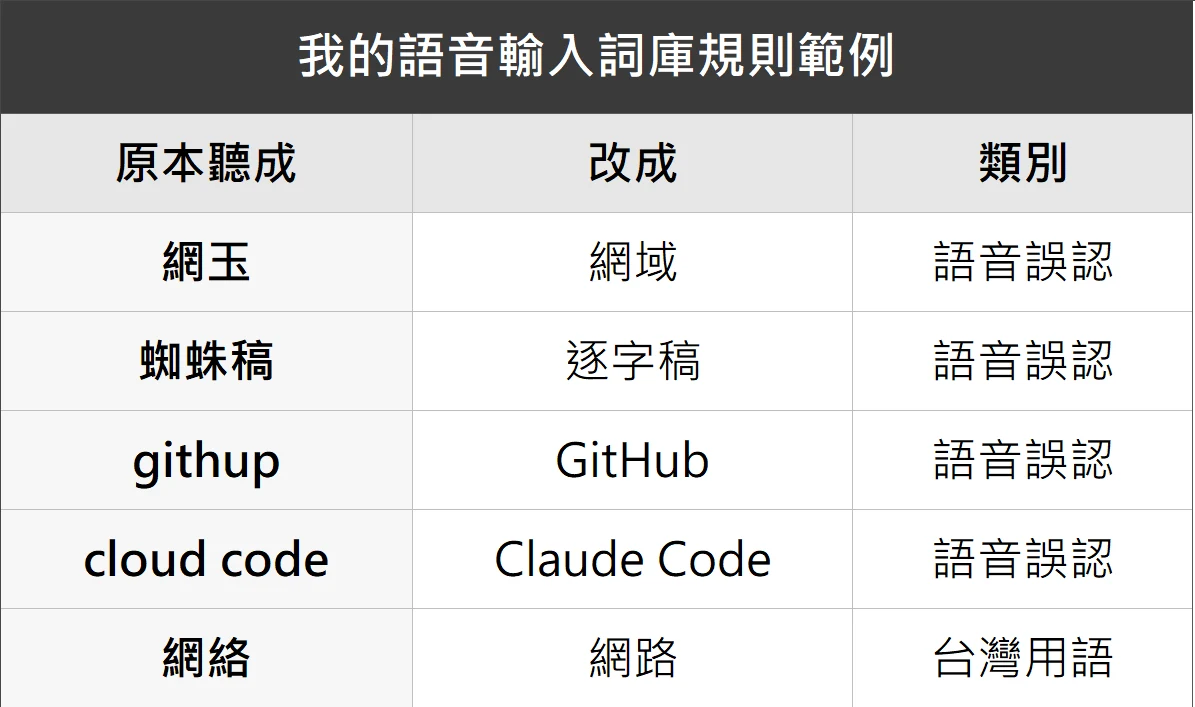
現在這份詞庫有 409 條規則,分 4 類:語音誤認 317 條、拼寫歸一 67 條、簡繁誤轉 13 條、台灣用語 12 條。分類的用處是,發現某條規則改壞東西時,可以回頭檢查同一類的規則有沒有同樣問題。
哪些錯字可以放進詞庫?我用 3 條原則篩
能放進詞庫的錯字,條件是錯的那個詞不可能是你本意。網玉幾乎不會是你想講的話,可以放;「快」被聽成「怪」就不能放,因為你真的想說怪的時候,也會被改成快。
- 錯字不會是本意:錯的那側是日常常用詞,就不要整個詞直接換。
- 發音要接近:聽寫的錯多半是音近,形近但音不像的字,對語音輸入參考價值低。
- 只加真的出現過的:我定期掃辨識歷史,挑高頻錯字再加規則,不去猜理論上可能聽錯的詞。我要加群主改群組這條之前,先數過紀錄,17 次講的都是群組,沒有一次在講群主。
熱詞欄有用嗎?先確認它真的有生效
很多語音輸入工具有熱詞欄,讓你填常用詞,提高辨識時選到它的機會,但設定頁看得到不代表有在用。我用的語音輸入軟體是聲聲慢(SpeakSlow),我翻過它的程式碼,日常錄音走的離線辨識根本沒把熱詞傳進去,只有串流模式吃熱詞,安裝檔又沒附串流模型。所以對我來說,真正有效的是詞庫。
每個工具做法不同。以 Wispr Flow 為例,官方字典說明寫了兩種用法:把名字或術語加進字典讓它認得,或加一條修正,把一直出現的錯誤拼法換掉。桌面版每個欄位上限 60 個字元,可以一次匯入最多 1,000 筆。加完詞之後,馬上講一句含那個詞的話測一次,還是錯就改用修正。
語音輸入英文亂拼,改一個詞卻改壞另一個?
用詞庫修英文亂拼,最容易踩的坑是改對一個字,連帶改壞另一個字。原因是多數詞庫做的是子字串取代:字串裡只要出現那幾個字母,不管是不是獨立的單字,都會被換掉。
為什麼 cloudflare 會變成 Claudeflare?
2026 年 8 月 2 日,我打出來的 cloudflare 變成了 Claudeflare。因為 Claude 常被聽成 cloud,我加了一條 cloud → Claude;詞庫用純子字串取代,cloudflare 裡面的 cloud 也一起被換了。同樣的道理,修 light 的規則也會把 highlight 改成 highLite。
判斷會不會出事很簡單:錯字本身是常用英文單字,像 cloud、light,就一定會撞到包含它的其他字。這時候要幫規則加邊界。
詞界取代怎麼寫?3 種寫法對照
詞界取代的意思,是只換獨立成一個詞的錯字,前後黏著其他字母就不換。我的工具只能把邊界直接寫進規則裡,先後試過兩種寫法。
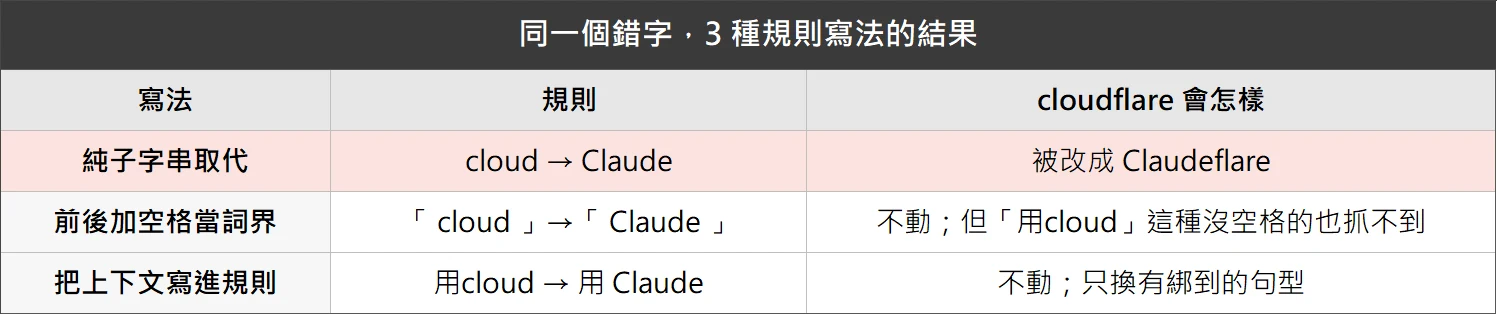
- 前後加空格:把 cloud 和 Claude 前後各留一格空白再寫成規則,cloudflare 就不會被動到。缺點是中文句子裡的英文前後常常沒空格,像
用cloud就抓不到。 - 把上下文寫進規則:不寫單獨的 cloud,改寫
用cloud → 用 Claude、cloud的 → Claude 的這種綁定前後字的規則。2026 年 10 月我一次補了 93 條這類規則(修 Claude 和 SEO 兩個詞),cloudflare、icloud 都不受影響。
如果你的工具支援規則運算式,可以直接用 \b 詞界符號。依 MDN 的詞界說明,英文字母、數字和底線才算單字字元,所以 \bcloud\b 碰不到 cloudflare;中文字不算單字字元,用cloud的 這種中英黏在一起的寫法還是比對得到。
加完規則,先跑一次不准改壞的測試
每次加規則,我會把全部規則套到自己寫對的 87 份文件上,只要有任何一個字被改動,就是誤傷候選。這個檢查第一次跑,就抓到 5 條正在用的規則會改壞正常文字,最誇張的是 skl 改 skill 那條,把 Windows 指令 tasklist 改成了 taskillist。
漏修你自己會發現,誤傷是靜默把對的改成錯的。
施文凱,詞庫工具的設計筆記
我另外留一份測試清單:每加一條規則,就補一句該修好的例句;每發現一次誤傷,就補一句不准被改動的例句。下次改規則時一起驗,同一個錯就不會犯第二次。
語音輸入開頭被吃掉?先分清楚沒錄到還是被刪掉
句子開頭不見,有兩個不同的成因:一個是錄到了、也辨識對了,卻在 AI 潤稿時被刪掉;另一個是按下錄音鍵後麥克風還沒準備好,聲音根本沒收進來。兩種修法不一樣,要先查清楚。
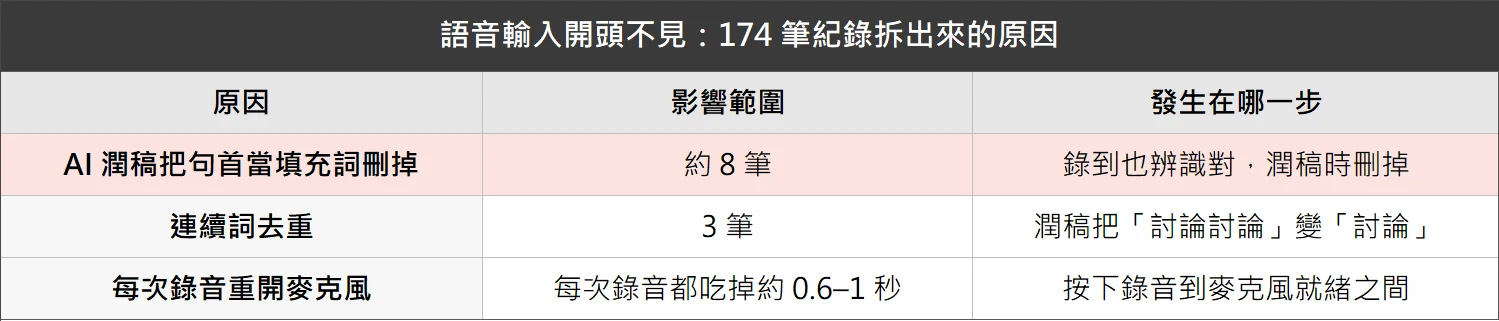
原因 1:AI 潤稿把句首當成贅字刪掉
我翻了 174 筆紀錄,有 11 筆開頭被刪:約 8 筆是 AI 潤稿把句首第一個詞當成填充詞刪掉,3 筆是連續詞去重,像討論討論被縮成討論。讓我發現這件事的那兩筆,被刪的都是「然後」,它在句子裡是有意思的連接詞。
查法是比對紀錄裡每一步的文字:辨識輸出和送進 AI 的文字,開頭都還在;AI 回傳的結果就不見了。問題出在潤稿指令要它刪除無意義的填充詞,我把那條改成「句首第一個詞不可刪除」,讓潤稿只清句子中間的贅字。想讓 AI 照規則改字、不要自己發揮,指令要寫到沒有模糊空間,可以參考怎麼讓 Claude 講人話。
原因 2:每次錄音都重開麥克風
另一個成因是語音輸入軟體每次錄音都重新打開麥克風,錄完就關掉。依 MDN 對 MediaStreamTrack.stop() 的說明,音軌停止後狀態就變成結束,下次錄音要重新跟系統要一次麥克風。我量到按下錄音鍵到麥克風就緒要 270 到 840 毫秒,加上裝置暖機,每次開頭會吃掉約 0.6 到 1 秒。
量法是用軟體 log 算:遺失秒數=停止錄音時間-開始錄音時間-實際音訊長度。處理方式從便宜到麻煩有 3 個:
- 按下錄音鍵後停半秒再開口,零成本、馬上有效。
- 重啟語音輸入軟體。我遺失最嚴重的那天,中位數到 1 秒,軟體已經連續開了 79 小時。
- 在軟體設定指定實體麥克風,不要留在預設。我自己另外改了程式,錄完延遲 30 秒才關麥克風,連續口述時就不用每次重開。
用 Whisper 轉逐字稿,專有名詞錯字怎麼修?
用 Whisper 轉影片或錄音的逐字稿,專有名詞錯字有兩道修法:轉錄前用 prompt 把正確拼法給它,轉錄後再過一份同音錯字表。
prompt 放正確拼法,不要放指令
根據 OpenAI 的語音轉文字說明,prompt 可以改善產品名、技術名詞和縮寫的辨識。用 whisper-1 時,作法是在 prompt 裡放一串正確拼法,上限 224 個 token。它不會像聊天模型那樣照指令做事,寫一句要它把 cloud 改成 Claude 沒有用,直接列 Claude Code, GitHub, Gemini 才有用。
在自己電腦跑開源版 Whisper 的話,對應的參數叫 initial_prompt。openai/whisper 的原始碼說明寫到,它只用在第一段音訊,要每一段都帶上得另外開 carry_initial_prompt。長影片後半段專有名詞又錯回去,可以先查這個設定。
清單太長、塞不進 prompt 時,OpenAI 建議的另一條路是轉完再交給文字模型修,並且要對照原音檢查,避免改掉講者真正說的話。這跟前面 AI 潤稿刪掉句首是同一個風險。
轉完再過一份同音錯字表
Whisper 轉得再好,每個講者還是有固定會被聽錯的詞,轉完要再過一份講者專屬的同音錯字表。我幫一場 29 分鐘的訪談做逐字稿時,即時語音辨識的版本同音錯字超過 100 處;改用 Whisper 好很多,但平倉還是被轉成平昌、均線被轉成金線,這種就寫進錯字表,下次同一位講者直接套用。
反過來,用 Whisper 校對 AI 配音旁白時,錯的可能是 Whisper。我做課程旁白時,Whisper 標出 6 處像念錯的地方,像機率被聽成紀律,我用耳朵一一確認,6 處其實都念對了。如果你用 AI 聲音克隆做旁白,Whisper 標出的疑點也先自己聽過,再決定要不要重錄。
常見問答
語音輸入的自訂詞庫和熱詞差在哪?
詞庫是辨識完成後照表把錯字換成正確的字,每次辨識都會跑。熱詞是辨識時提高某些詞被選中的機會,要看工具的辨識模式有沒有支援;我用的軟體日常走離線辨識,熱詞完全沒作用,有效的是詞庫。
自訂詞庫要加多少條規則才夠?
沒有固定數字,我的詞庫從 47 條慢慢長到現在的 409 條。每條都是辨識紀錄裡真的出現過的錯字,定期掃一次歷史紀錄、挑高頻錯字再加,比一次窮舉所有可能的錯字有用。
英文單字被詞庫改壞了,要怎麼救?
先找出錯字側剛好是常用英文單字的規則,像 cloud、light。把規則改成前後加空格,或寫成「用cloud」這種綁上下文的寫法;工具支援規則運算式就用 \b 詞界。改完套到自己寫對的文件上跑一次,確認沒有其他字被動到。
Whisper 的 prompt 可以放多長?要寫什麼?
依 OpenAI 官方說明,whisper-1 的 prompt 上限 224 個 token。內容放產品名、縮寫這類正確拼法的清單,不要寫成指令句,Whisper 不會照指令做。清單太長就改成轉完再用文字模型修,並對照原音檢查。
語音輸入開頭被吃掉,最快的解法是什麼?
最快的是按下錄音鍵後停半秒再開口,避開麥克風開啟那 0.6 到 1 秒。停了還是缺字,就看紀錄裡 AI 潤稿前後的文字,潤稿前還在、潤稿後不見,要改的是潤稿指令。
語音輸入 自訂詞庫不會建?可以找 AI 家教施文凱
語音輸入聽錯,先分是哪一種:專有名詞和英文用詞庫修,常用英文單字記得加詞界或綁上下文,加完跑一次不准改壞的測試;開頭不見,就去查錄音和 AI 潤稿那兩步。Whisper 轉逐字稿則是 prompt 放正確拼法,轉完再過同音錯字表。
想把語音輸入接進你自己或團隊的 AI 工作流程,或想有人陪你把詞庫建起來,可以看我的一對一 AI 教學,也可以直接加 LINE 問我:官方 LINE。延伸閱讀:還沒設定過語音輸入,先看 AI 語音輸入教學,裡面有各裝置的開法和下指令要講的 3 件事。
本文依各工具官方文件與我自己的詞庫、錄音紀錄整理,最後核對日期為 2026 年 11 月 3 日,功能以官方頁面為準。
參考資料來源
- OpenAI API Docs:Speech to text(Prompting、Improving reliability)
- openai/whisper GitHub:transcribe.py 的 initial_prompt 參數說明
- Wispr Flow Help Center:Teach Flow your words with the dictionary
- MDN Web Docs:Word boundary assertion
- MDN Web Docs:MediaStreamTrack.stop()
最後核對日期為 2026 年 11 月 3 日。