Grok 4.7 是 xAI 目前的旗艦模型,主打寫程式和需要好幾個步驟的工作。這篇整理它的規格、官方評測贏在哪輸在哪、和 Grok 4.6 該怎麼比,以及單價沒漲、帳單卻可能變貴的原因。也會附上 Grok 各版本的時間軸,從 Grok-1 到 Grok 4.7,還有 2026 年 11 月的價格與可用平台。最後依你的情況,給出要不要現在就換的建議。
Grok 4.7 是什麼?
Grok 4.7 是 xAI(官方文件現在署名為 SpaceXSI)在 2026 年 9 月 21 日發布的旗艦模型,定位是寫程式與知識工作。官方的說法是,它能在困難任務上工作更久、更仔細檢查自己的成果,價格和速度則和 Grok 4.6 相同。
| 項目 | 內容(截至 2026 年 11 月) |
|---|---|
| 發布日期 | 2026 年 9 月 21 日 |
| API 模型名稱 | grok-4.7 |
| 上下文視窗 | 50 萬 token |
| 知識截止 | 2026 年 5 月 |
| 推理強度 | low、medium、high(預設)、xhigh |
| API 價格 | 每 100 萬 token 輸入 2 美元、輸出 6 美元起 |
規格取自 xAI 官方模型頁。推理強度是可以調的旋鈕,檔位越高,想得越多、分數越高,但也越慢、越貴。知識停在 2026 年 5 月,沒開搜尋工具時,它不知道之後發生的事。
官方提到 4.7 換了比 4.6 更大的基礎模型,用更長的強化學習訓練,題目偏向要花好幾個小時才能完成的難題,也特別針對 Grok Bot 的執行環境訓練。參數規模官方沒有公布,網路上流傳的「2.1 兆參數」並沒有官方依據。
Grok 模型版本一覽:從 Grok-1 到 Grok 4.7
Grok 的版本更新得很快,2026 年下半年差不多每個月一版。
| 時間 | 版本 |
|---|---|
| 2024 年 3 月 | Grok-1 以開放權重釋出 |
| 2024 年 8 月 | Grok 2,接入 Flux 開始能生圖 |
| 2025 年 2 月 | Grok 3 |
| 2025 年 7 月 | Grok 4 |
| 2026 年 7 月 8 日 | Grok 4.5 |
| 2026 年 8 月 12 日 | Grok 4.6 |
| 2026 年 9 月 21 日 | Grok 4.7 |
目前 API 上同時還能用 grok-4.6、grok-4.5、grok-4.3 和寫程式用的 grok-build-0.1,舊版本沒有因為新版推出而下架。語音則是另一條產品線,目前的語音對話模型是 grok-voice-3.0。
Grok 4.7 官方評測:贏在哪、輸在哪?
依 xAI 的 Grok 4.7 發布說明,Grok 4.7 在法律與電子工程兩項評測拿第一,其餘多數項目由 Anthropic 的 Fable 5.1 領先。下表是官方公布的成績,各模型的推理檔位不同:Grok 4.7 用 xhigh、Grok 4.6 用 high、另兩家用 max。
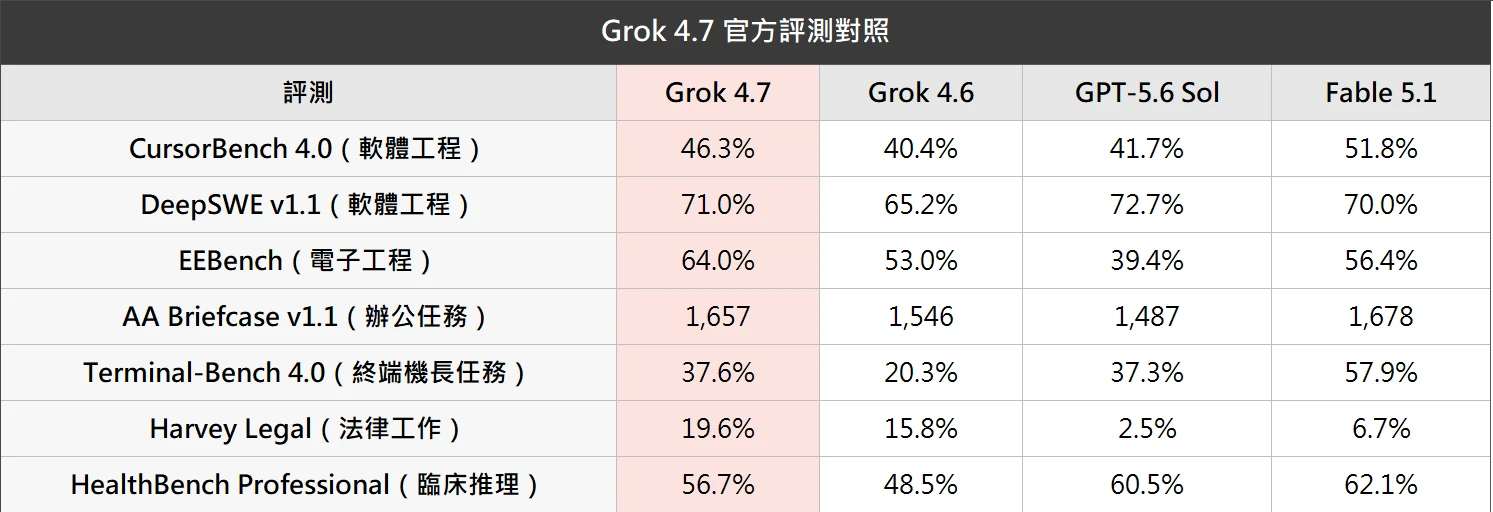
Grok 4.7 每一項都比 4.6 進步,但多數項目的第一名仍是別人。進步最大的是 Terminal-Bench,從 20.3% 拉到 37.6%,接近翻倍;DeepSWE 的 71.0% 官方特別註明是用 high 檔跑的。要注意,這張表由 xAI 自己整理,其他家模型的分數取自各家公開的最佳成績,比較基準不完全一致。
分數的絕對值也要會讀。Harvey Legal 的 19.6% 是全場最高,但還不到兩成,代表這類專業代理任務對所有模型都很難。分數比較適合用來決定「哪些工作值得自己測」,不能當成你的工作一定會成功的保證。
Grok 4.7 跟 4.6 差多少?比較前先避開 3 個陷阱
同版本、同推理檔位比較,Grok 4.7 確實比 4.6 進步,但幅度比官方表呈現的小一些。網路上常見的誤讀,多半出在下面 3 個地方。
陷阱 1:評測版本不同
4.6 發布時用的是 CursorBench v3.2,4.6 拿 69.9%;4.7 改用新版 CursorBench 4.0,同一個 4.6 只剩 40.4%。拿 69.9% 對 46.3%,會以為 4.7 大退步,其實是兩把不同的尺。同一版本內比,4.7 比 4.6 多 5.9 個百分點。
陷阱 2:推理檔位不同
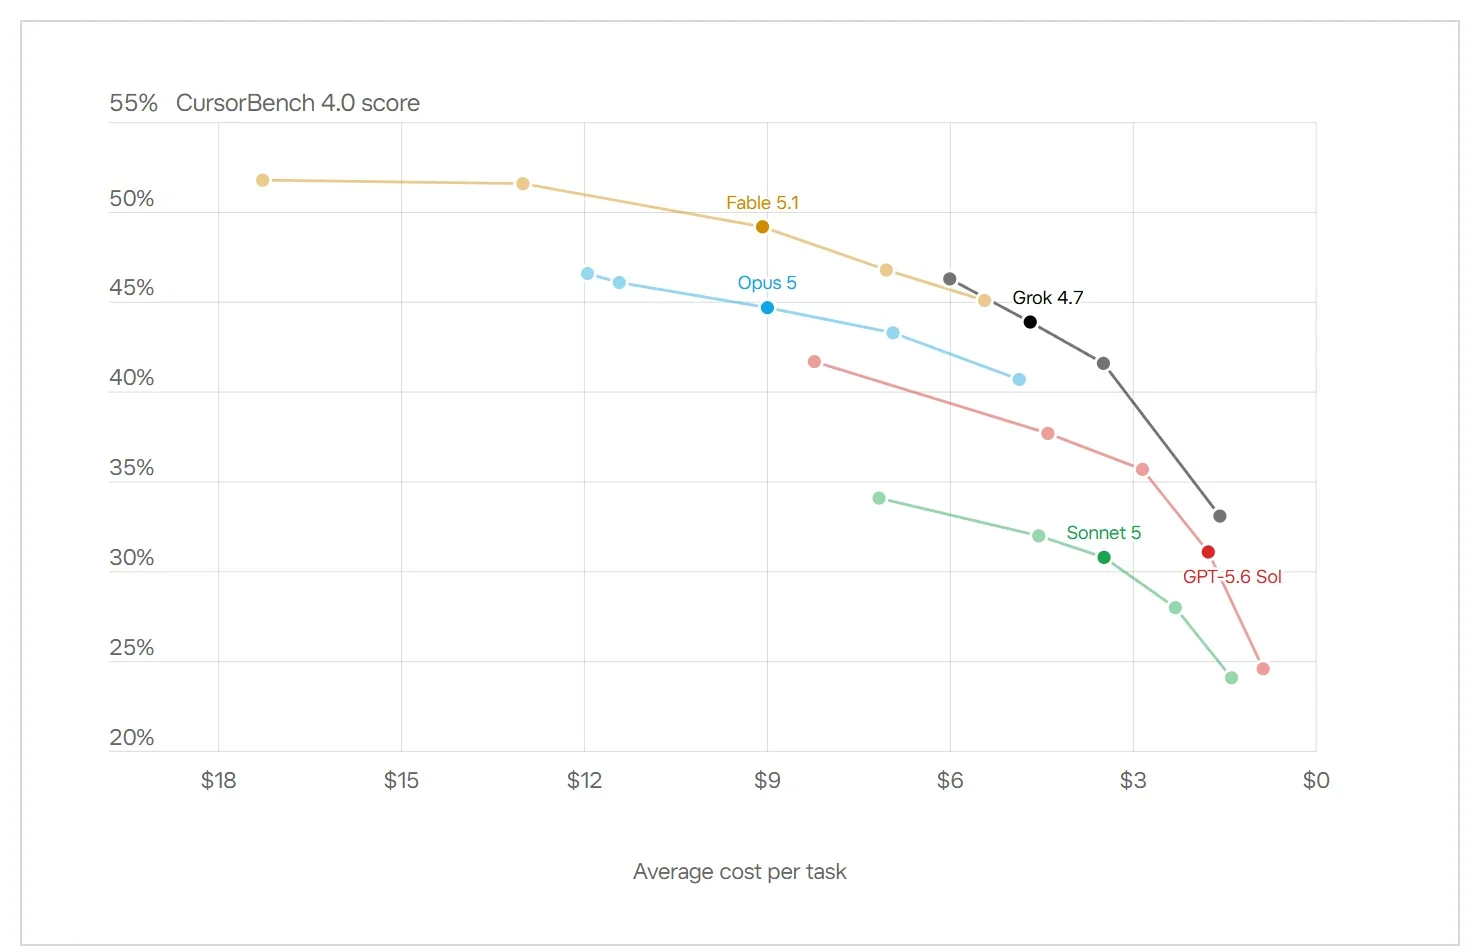
官方表拿 4.7 的 xhigh 對 4.6 的 high。依 Cursor 公布的評測資料重新對齊後,high 對 high 是 40.4% 對 43.9%,xhigh 對 xhigh 是 41.4% 對 46.3%。同檔比較仍是升級,只是 3.5 到 4.9 個百分點,比表上的差距小。
陷阱 3:排行榜還在變動
Artificial Analysis 的綜合指數給 4.7 46 分,比 4.6 只高 2 分;不同榜單在發布頭幾週名次都還在調整。任何單一榜單都不是定論,拿你自己的任務各跑一次最準。
Token 消耗爭議:單價沒漲,帳單為什麼可能變貴?
Grok 4.7 的單價和 4.6 一樣,但同一個任務可能寫出兩倍的輸出量。Artificial Analysis 實測,4.7 用 xhigh 檔時,每個任務平均輸出約 8.1 萬個 token,4.6 同檔只要約 3.8 萬個。輸出又是計費最貴的部分,同一張價目表,帳單可能差一倍。
用一個示意試算來看:同樣送進 5 萬個已快取的 token,4.7 若輸出 8.1 萬個,費用約 0.51 美元;4.6 輸出 3.8 萬個,約 0.25 美元。原因很可能是 4.7 被訓練成多想幾步、多檢查一遍,能力和成本是同一個選擇的兩面。
不過在 Cursor 的評測裡,4.7 xhigh 每個任務約 6.01 美元,4.6 xhigh 約 6.10 美元,成本幾乎一樣、分數卻更高。不同評測結果不同,代表你的帳單取決於你的任務長什麼樣子。評估時,挑一個平常真的要跑的任務,兩個版本各跑一次,記下總 token、完成品質和人工修正時間。
Grok 4.7 價格完整拆解
Grok 4.7 的 API 價格分兩段,以單次請求的提示長度 20 萬 token 為界,達到之後整筆請求改按兩倍計費。以下取自 xAI 官方 API 價目表,截至 2026 年 11 月。
| 計費項目(每 100 萬 token) | 提示未達 20 萬 | 達 20 萬以上 |
|---|---|---|
| 輸入 | 2 美元 | 4 美元 |
| 快取輸入 | 0.5 美元 | 1 美元 |
| 輸出 | 6 美元 | 12 美元 |
另外幾個會影響帳單的設定:
- Fast 版:速度兩倍、價格兩倍(超過 20 萬 token 時為 1.5 倍),只在 Cursor 與 Grok Build 提供,公開 API 沒有。
- Batch API:不急的工作改用批次處理,grok-4.7 打 8 折,通常在 24 小時內完成。
- 優先處理:所有 token 費率乘以 2,適合尖峰時段會卡的即時應用。
- 美國區域端點:資料要留在美國處理時使用,費率乘以 1.1。
對照競品的官方牌價,GPT-5.6 Sol 是輸入 4 美元、輸出 20 美元,Fable 5.1 是輸入 10 美元、輸出 50 美元;Anthropic 11 月 9 日推出的 Fable 5.2 降到輸入 8 美元、輸出 40 美元。只看單價,Grok 4.7 明顯便宜,但實際輸出量也要一起算進去。
哪裡可以用 Grok 4.7?
Grok 4.7 發布當天就在 Cursor、Grok Build 和 xAI API 上線,同一天也開始在 GitHub Copilot 漸進開放。
- xAI API:模型名稱 grok-4.7,上下文 50 萬 token。
- Cursor:個人與團隊方案都能用,標準上下文 25.6 萬 token,更長的請求按長上下文費率計費。
- Grok Build:xAI 的終端機寫程式代理,我在 Grok Build 教學有完整安裝步驟。
- GitHub Copilot:Pro、Pro+、Business、Enterprise 等方案漸進開放,企業版由管理員決定是否啟用(見 GitHub 更新公告)。
在 grok.com 和 Grok App 上能不能選到 4.7,依你的方案而定,以帳號裡的模型選單為準。官方沒有公布對台灣的使用限制,API 與開發者平台以美元計價,用信用卡付款。
要不要換 Grok 4.7?4 種情況的判斷
Grok 4.7 的定位是「分數接近第一梯隊、單價明顯較低的日常工作模型」,不是全面的第一名。要不要換,看你屬於哪一種情況。
| 你的情況 | 建議做法 |
|---|---|
| API 已經在用 Grok 4.6 | 正式流程先維持 4.6,挑 10 到 20 個真實任務兩邊各跑一次,比較品質與 token 用量再切換 |
| 在 Cursor 裡寫程式 | 直接在模型選單選 4.7,從 high 檔開始,xhigh 留給真的卡住的難題 |
| 正在比較不同家模型 | 拿自己的任務實測 Fable 5.1、GPT 系列和 4.7,不要只看單一廠商的評測表 |
| 只在手機上聊天 | 不用特地為 4.7 換方案,等你用的入口更新再說 |
推理檔位怎麼選也有一個簡單原則:日常工作多半 medium 或 high 就夠,xhigh 只留給難題,因為檔位越高,輸出的 token 越多、帳單越貴。
Grok 4.7 的安全宣稱:官方說到哪裡
xAI 表示 Grok 4.7 是它測過的模型裡,拒答與抗越獄能力最強的:在 LatchBio 生物安全評測拿到 62.4%,在自家的 HackerBench v0.3 只放行 3.3% 有風險的雙重用途提示。這些都是廠商自己公布的數字,目前沒有獨立第三方複核。
這些分數量的是模型會不會被誘導做出危險回答,不保證你的資料不外洩,也不保證輸出正確。機敏資料怎麼處理,要看平台的資料政策,輸出還是要人工檢查。我另外整理了 Grok 安全嗎,談外洩事件與自保做法。
Grok 4.7 的限制與傳聞
- 知識停在 2026 年 5 月:要即時資訊得開啟搜尋工具,按次計費。
- 只輸出文字:要生圖得改用 Imagine API。
- 參數規模未公布:「2.1 兆參數」屬未證實的說法。
- 長任務仍常失敗:Terminal-Bench 的 37.6% 代表三段任務裡將近兩段沒過,導入時要預留人工接手的時間。
- 版本一個月一版:流程不要綁死在單一模型上。
常見問答
Grok 4.7 跟 Claude Fable 5.1 比哪個強?
依 xAI 公布的評測,Fable 5.1 在 CursorBench、Terminal-Bench、AA Briefcase、HealthBench 四項領先,Grok 4.7 贏在法律和電子工程。Grok 4.7 的優勢在價格,輸出單價約是 Fable 5.1 的八分之一。Claude 這一側的差異,可以看我整理的 Claude Fable 5 用法。
Grok 4.7 要怎麼開始用?
最快的方式是在 Cursor 的模型選單選 grok-4.7,或安裝 Grok Build。用 API 則需要先儲值,按用量計費。
舊程式寫 grok-4.6,會自動變成 4.7 嗎?
不會,寫明 grok-4.6 就會一直用 4.6,官方也沒有公布 4.6 的退役時間。要注意的是,如果你的程式用的是自動指向最新版的別名,換版時模型可能跟著變,正式系統建議明確寫出版本名稱。
結語:Grok 4.7 值得測,AI 家教施文凱建議先別全面切換
開發者值得馬上做一輪測試:同價、同速率限制,程式和終端機任務的進步是真的。但同樣要記下 token 用量,單任務成本才是決定要不要換的關鍵。只是偶爾聊天的一般使用者,不需要為了 4.7 特地調整任何設定。
想知道你的工作該用 Grok 4.7、Claude 還是 ChatGPT,或想把 Grok 接進公司流程,可以加 LINE 找 AI 家教施文凱,我們用你手上的真實任務一起測。先跑一次,數字會告訴你答案。
參考資料來源
- xAI 官方 Grok 4.7 發布說明
- xAI 官方模型頁
- xAI 官方 API 價目表
- Cursor 模型評測
- Artificial Analysis:Grok 4.7 評測
- GitHub:Grok 4.7 在 Copilot 上線
最後核對日期:2026 年 11 月 12 日